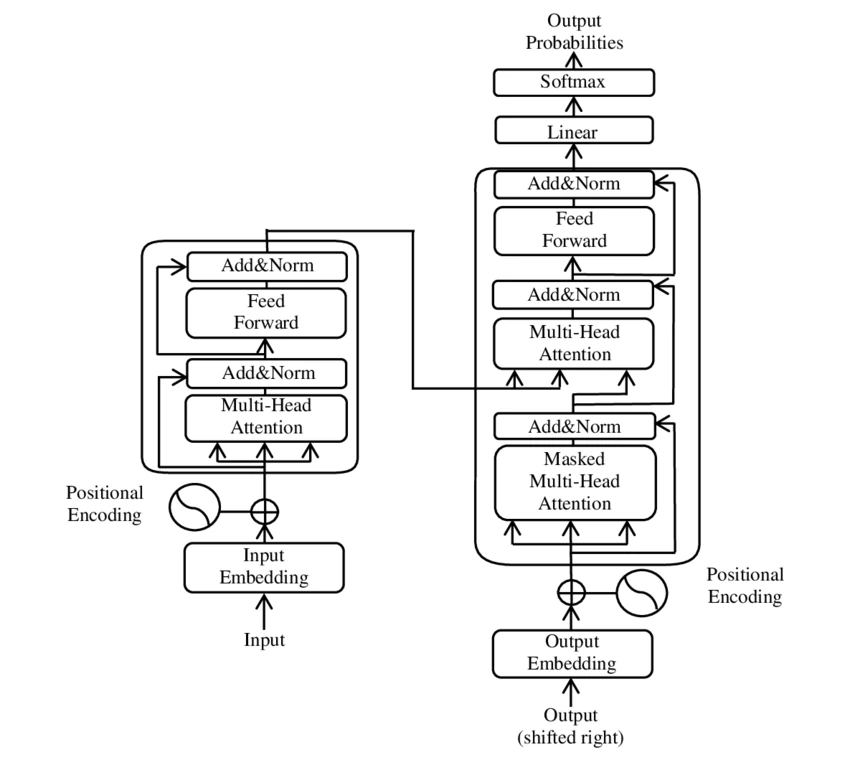
Em junho de 2017, oito pesquisadores do Google publicaram um artigo científico com um título que soava quase modesto diante do que continha, Attention Is All You Need, ou seja, “atenção é tudo de que você precisa”. O texto, assinado por Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan Gomez, Łukasz Kaiser e Illia Polosukhin, propunha uma arquitetura de rede neural chamada Transformer, como mostra o paper original no arXiv.
O objetivo declarado era melhorar a tradução automática, porém o que saiu dali foi a fundação sobre a qual praticamente toda a inteligência artificial generativa foi construída, já que o ChatGPT, o Gemini e o Claude são, todos, Transformers. O paper aparece em sétimo lugar na lista dos artigos científicos mais citados do século 21, segundo o levantamento da revista Nature publicado em abril de 2025.
Vale entender o que ele resolveu, porque a resposta explica também como a IA enxerga a sua empresa hoje.
 (ampliar imagem)
O problema: modelos que liam o texto como uma fita cassete
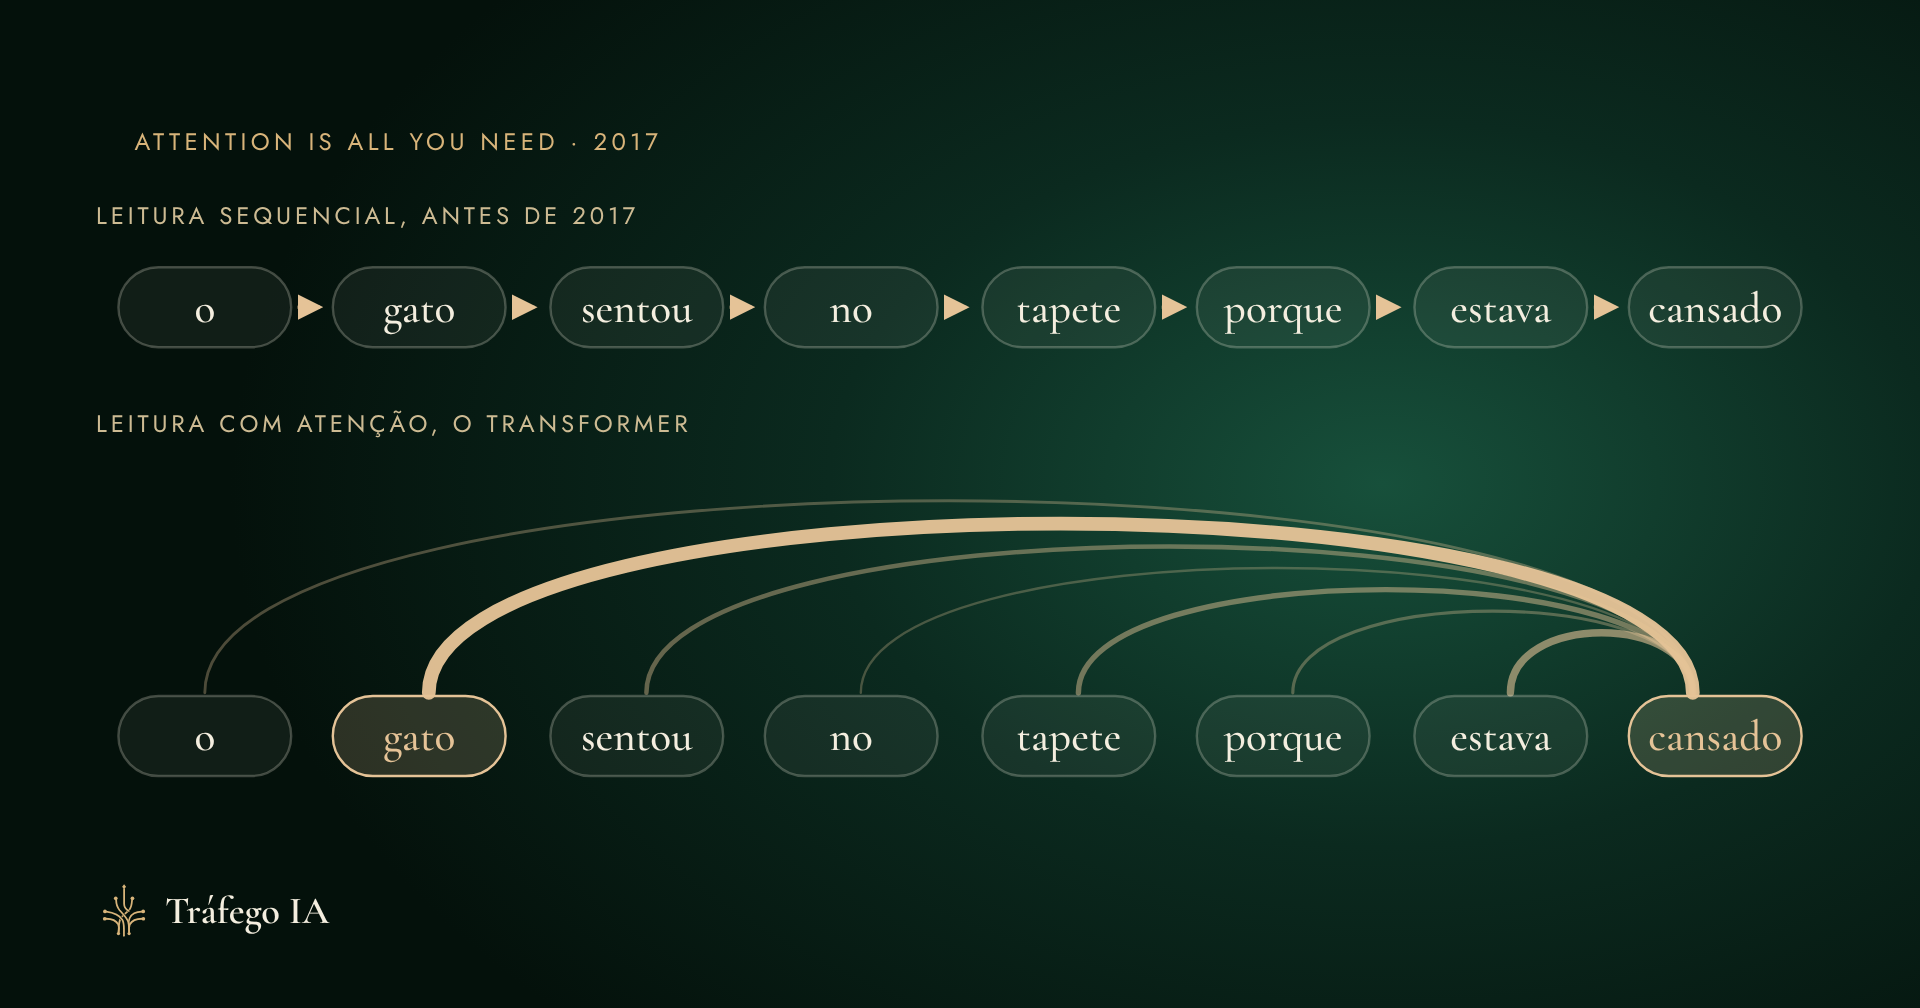
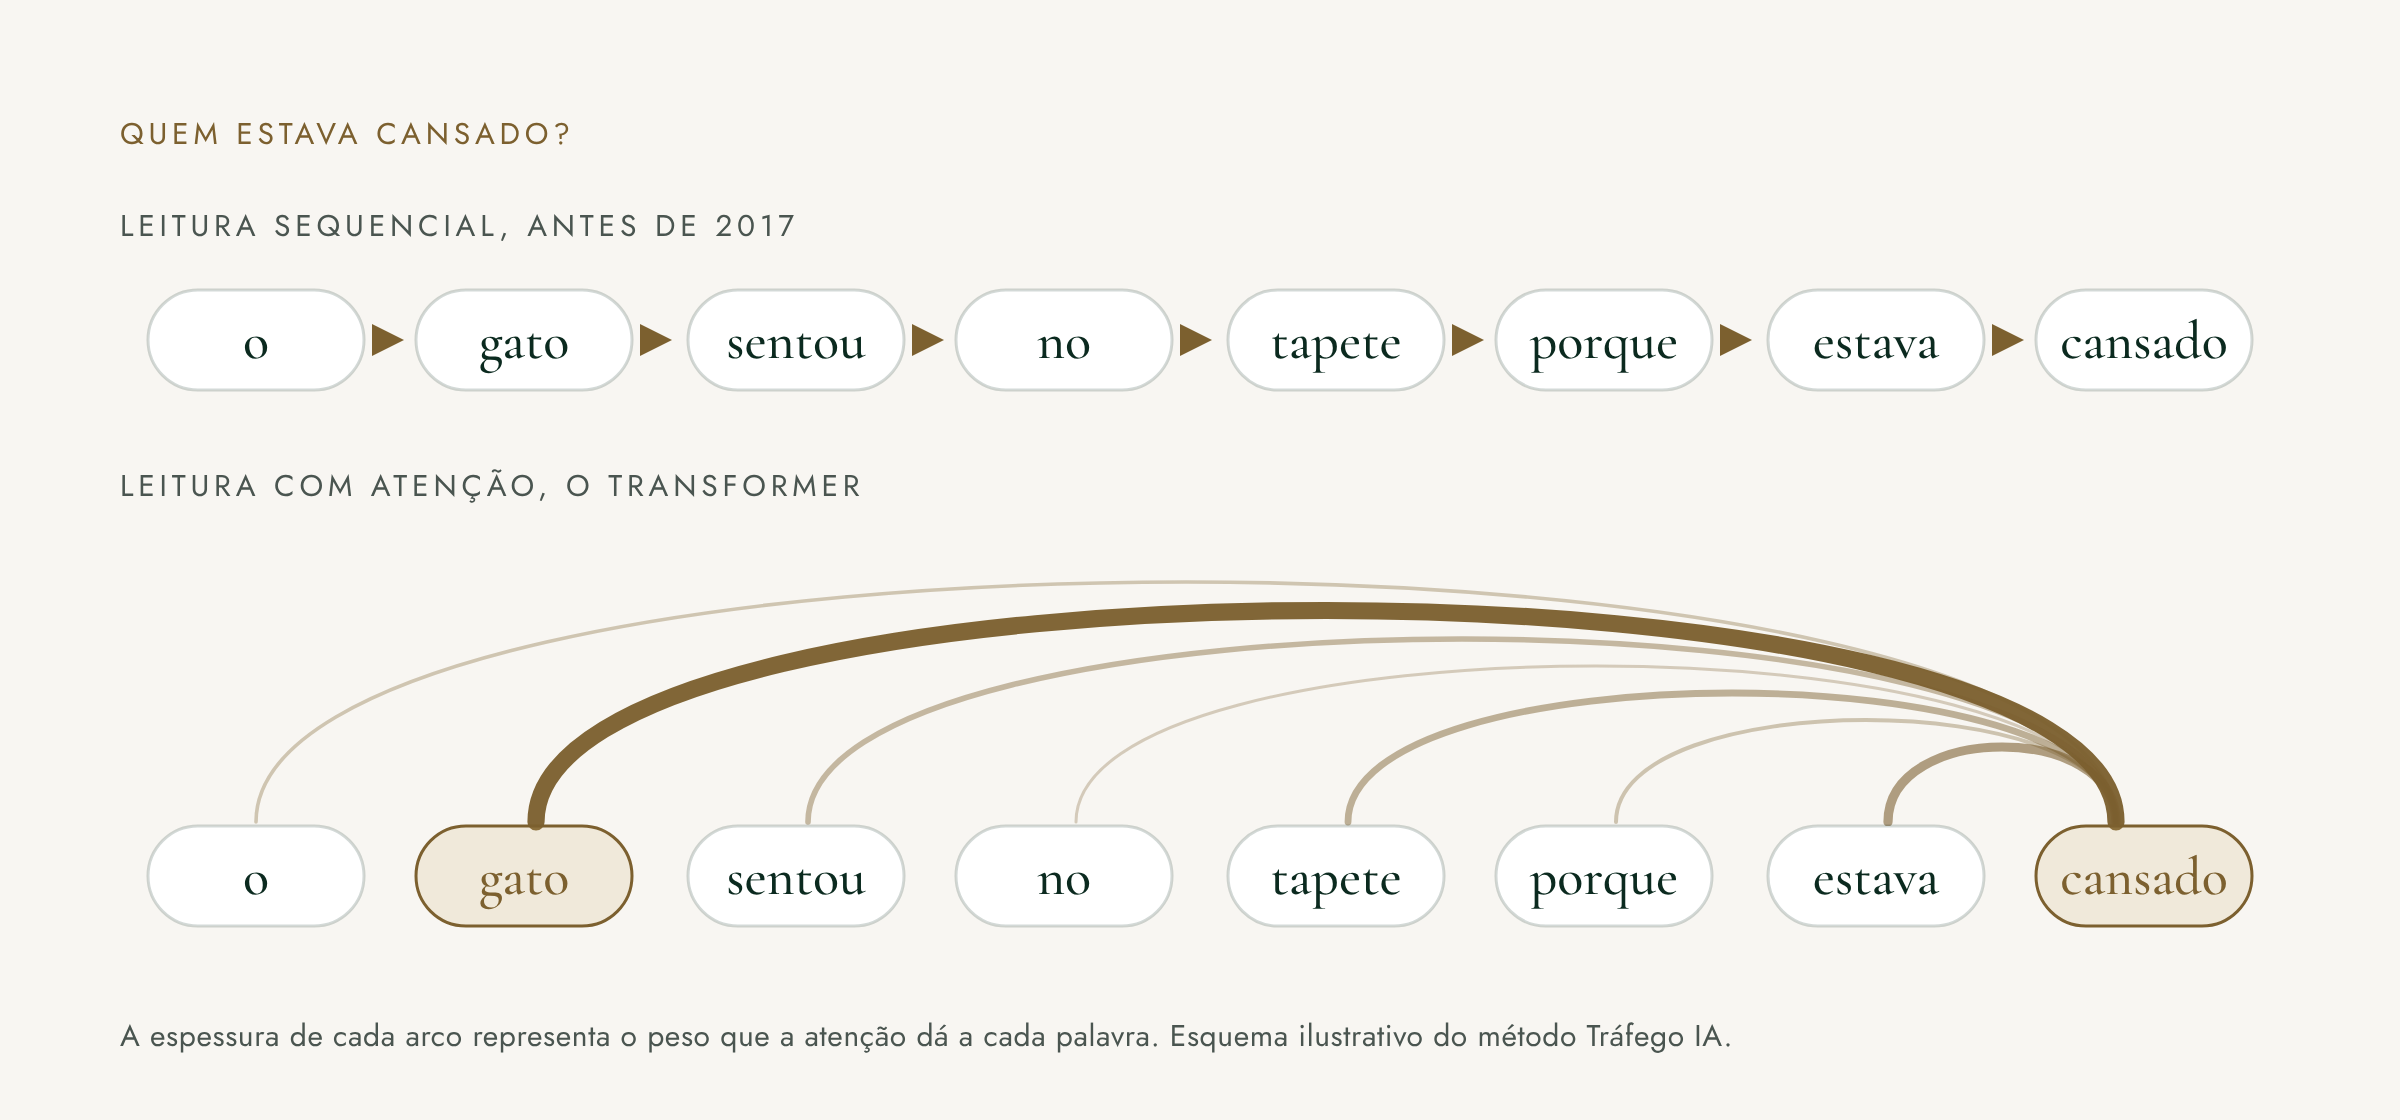
Antes de 2017, os modelos de linguagem dominantes, as redes recorrentes e as LSTMs, processavam o texto de forma sequencial, uma palavra de cada vez, da esquerda para a direita, de modo que, quando a frase era longa, a informação do início chegava ao final atenuada, quase perdida. Era como ouvir uma fita cassete, do começo ao fim, sem poder voltar.
Na prática, isso impunha um teto de capacidade, porque frases curtas funcionavam, enquanto textos longos, com uma referência no parágrafo dez que dependia de algo dito no parágrafo dois, simplesmente escapavam do modelo. E havia um segundo custo, já que processar palavra por palavra impedia paralelizar o treinamento, o que tornava tudo lento e caro.

Antes do Transformer, a máquina lia como quem ouve uma fita cassete, do começo ao fim, sem poder voltar
O que a atenção fez de diferente
A inovação central do paper foi o mecanismo de self-attention, a autoatenção, em que o modelo, em vez de ler palavra por palavra, passa a enxergar a frase inteira de uma vez e calcula, para cada termo, a relevância de todos os outros.
Pense na frase “o gato sentou no tapete porque estava cansado” e na pergunta sobre quem estava cansado, o gato ou o tapete. Para uma pessoa, a resposta é imediata, porém, para uma máquina, ela exige compreender a relação entre termos separados na frase, e é exatamente isso que a atenção faz, ao pesar quais palavras devem “olhar” para quais outras. Em outras palavras, o Transformer passou a ler como você lê uma página, vendo o todo e percebendo as relações entre as partes.
 (ampliar imagem)
O resultado apareceu de imediato nos testes de tradução, com qualidade superior à dos modelos anteriores e uma fração do custo de treinamento. E, como a arquitetura permitia processar grandes volumes de dados em paralelo, ela escalava, ou seja, quanto mais dados e mais computação, melhor o modelo ficava, e essa propriedade, mais do que qualquer outra, acendeu a corrida que estamos vendo até agora.
 (ampliar imagem)
Do paper ao produto que está no seu bolso
Um detalhe notável dessa história é que o Google criou a arquitetura, mas não foi o primeiro a escalá-la de forma agressiva num produto de massa. Quem fez isso foi a OpenAI, com o GPT, sigla que já entrega a genealogia, Generative Pre-trained Transformer, e cada versão do ChatGPT é uma variação cada vez maior da mesma base descrita em 2017, o que vale também para o Gemini, para o Claude e para os modelos abertos da Meta.
A escala alcançada dá a dimensão do que aquelas páginas inauguraram, já que o ChatGPT chegou a 1,2 bilhão de pessoas por semana em outubro de 2026, segundo a OpenAI. O Google, por sua vez, anunciou em julho de 2025 que as AI Overviews, as respostas geradas por IA no topo da busca, já tinham mais de 2 bilhões de usuários por mês em mais de 200 países e territórios, como relatou o TechCrunch.
Por que isso importa para a sua empresa
Entender o Transformer vai além da curiosidade técnica, porque é entender como a IA lê, e isso tem consequência direta para qualquer negócio que queira ser citado e recomendado por esses sistemas.
O mecanismo de atenção não procura palavras-chave soltas, mas sim pesa relações entre termos, entre conceitos e entre entidades. Quando alguém pergunta ao ChatGPT “qual empresa de marketing digital você recomenda na minha cidade?”, o modelo executa um exercício de atenção sobre tudo o que aprendeu e sobre o que encontra nas fontes que consulta, observando quais entidades aparecem com dados consistentes, quais têm autoridade temática reconhecível e quais conseguem ser compreendidas sem ambiguidade.
A empresa que entra na resposta, portanto, é a que o modelo consegue entender com precisão, e não a que mais repetiu o próprio nome, o que passa por nome, endereço e telefone consistentes entre plataformas, conteúdo que sustenta autoridade no tema e dados estruturados que eliminam a dúvida de interpretação.
A arquitetura descrita naquelas páginas de 2017 explica por que estruturar a presença digital funciona
Estruturar essa presença é o trabalho do Tráfego IA, e quem entende como a máquina lê deixa de escrever para um robô que conta palavras e passa a construir, para um sistema que pesa relações, uma presença que ele consegue compreender e recomendar.
O Tráfego IA foi desenvolvido dentro da Diamantino Estratégias, que aplica o método na presença digital de empresas.