Todo campo novo de trabalho nasce cercado de números soltos, e, no GEO, o número que circula é “40%”, com páginas de venda prometendo aumentar a visibilidade da sua marca em 40% porque um estudo de Princeton disse isso. O estudo existe e o número também, mas a distância entre o que foi medido e o que as páginas de venda prometem é exatamente o assunto deste artigo.
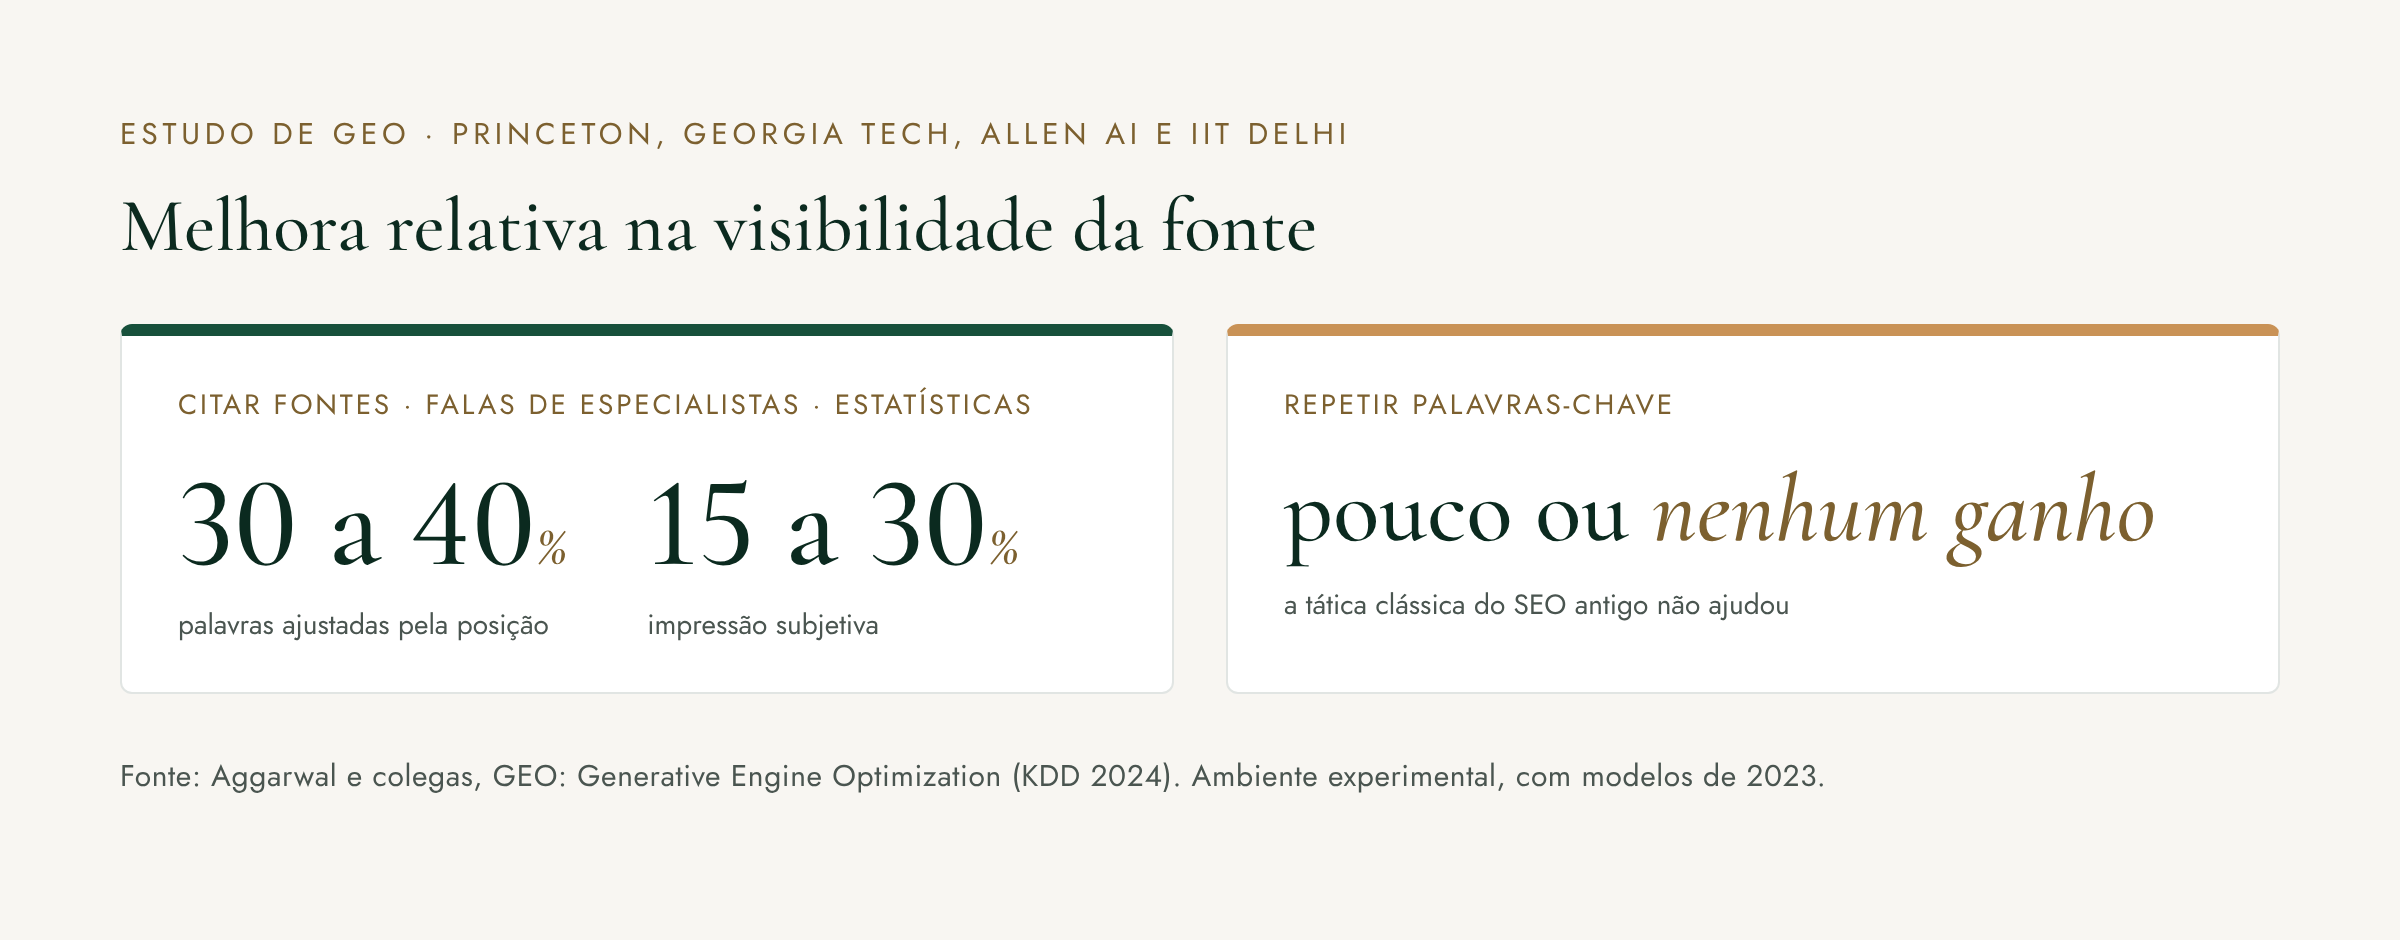
A pesquisa mais citada sobre GEO é a de Pranjal Aggarwal e colegas, publicada no arXiv em novembro de 2023 e apresentada na conferência ACM KDD em agosto de 2024, assinada por pesquisadores de Princeton, Georgia Tech, Allen Institute for AI e IIT Delhi, como mostra o artigo no arXiv. Em ambiente experimental, o estudo mostrou que acrescentar estatísticas, citações de fontes e falas de especialistas ao texto aumentou a visibilidade de uma fonte em respostas geradas por IA em cerca de 30% a 40%, e que repetir palavras-chave não ajudou.
É um resultado importante, porém limitado, já que o estudo não mediu tráfego, nem vendas, nem o comportamento do Google.
 (ampliar imagem)
O que o estudo fez
Os autores propuseram o termo Generative Engine Optimization e criaram um banco de testes, o GEO-bench, com consultas de vários domínios, para testar nove métodos de reescrita de conteúdo: acrescentar estatísticas, citar fontes, incluir falas de especialistas, adotar tom autoritativo, simplificar a linguagem, usar termos técnicos, melhorar a fluência, usar palavras menos comuns e repetir palavras-chave, este último funcionando como comparação com o SEO tradicional.
Para medir o efeito, usaram duas métricas. A primeira, a contagem de palavras ajustada pela posição, mede quantas palavras da resposta vêm de uma fonte, com peso maior para o que aparece primeiro, e a segunda, a impressão subjetiva, avalia a relevância e a influência da fonte dentro da resposta.
O teste principal usou um mecanismo generativo montado pelos próprios autores, que lia os cinco primeiros resultados do Google para cada consulta e gerava a resposta a partir deles com o GPT-3.5 Turbo, e uma parte dos testes foi repetida no Perplexity. Vale guardar esse detalhe, porque ele importa na hora de interpretar os resultados.
O que o estudo encontrou
- Os três métodos de melhor desempenho foram citar fontes, acrescentar falas de especialistas e acrescentar estatísticas, com melhora relativa de 30% a 40% na métrica de palavras ajustada pela posição e de 15% a 30% na impressão subjetiva.
- A repetição de palavras-chave trouxe pouco ou nenhum ganho.
- O efeito variou por tipo de pergunta, com o tom autoritativo funcionando melhor em perguntas de debate ou históricas e a citação de fontes ajudando mais nas factuais.
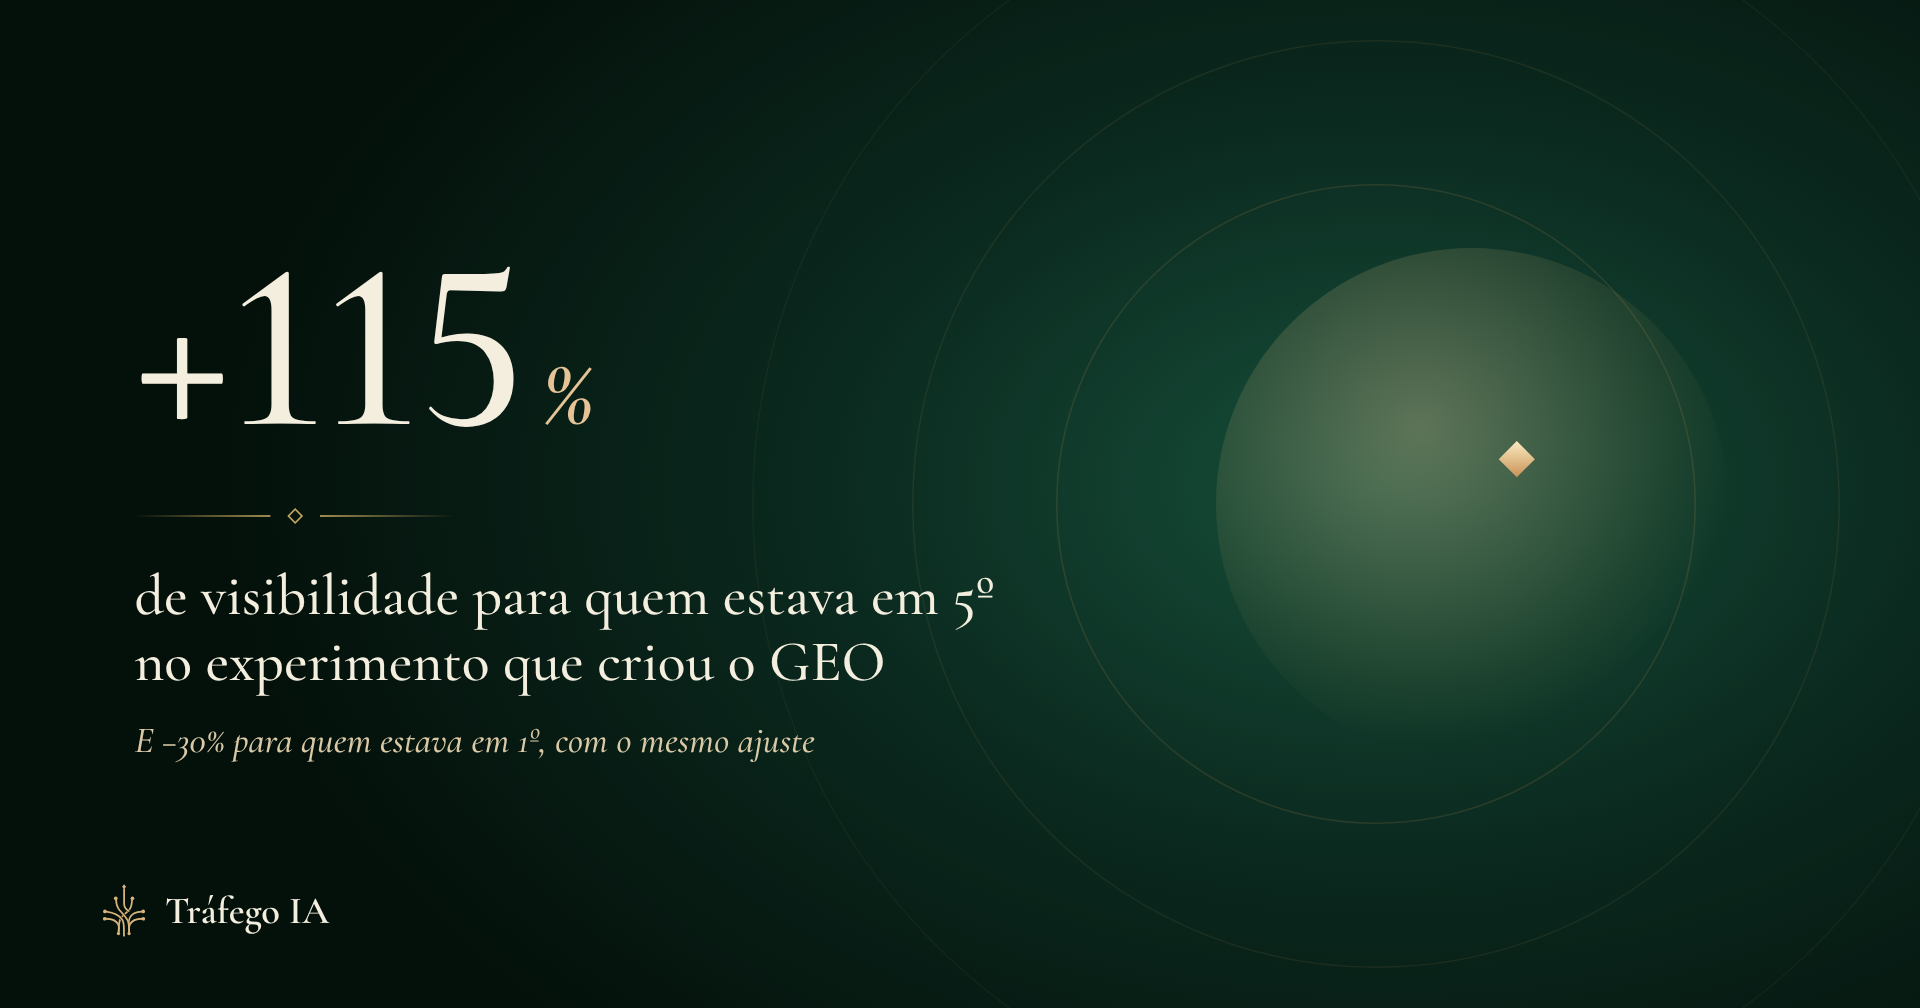
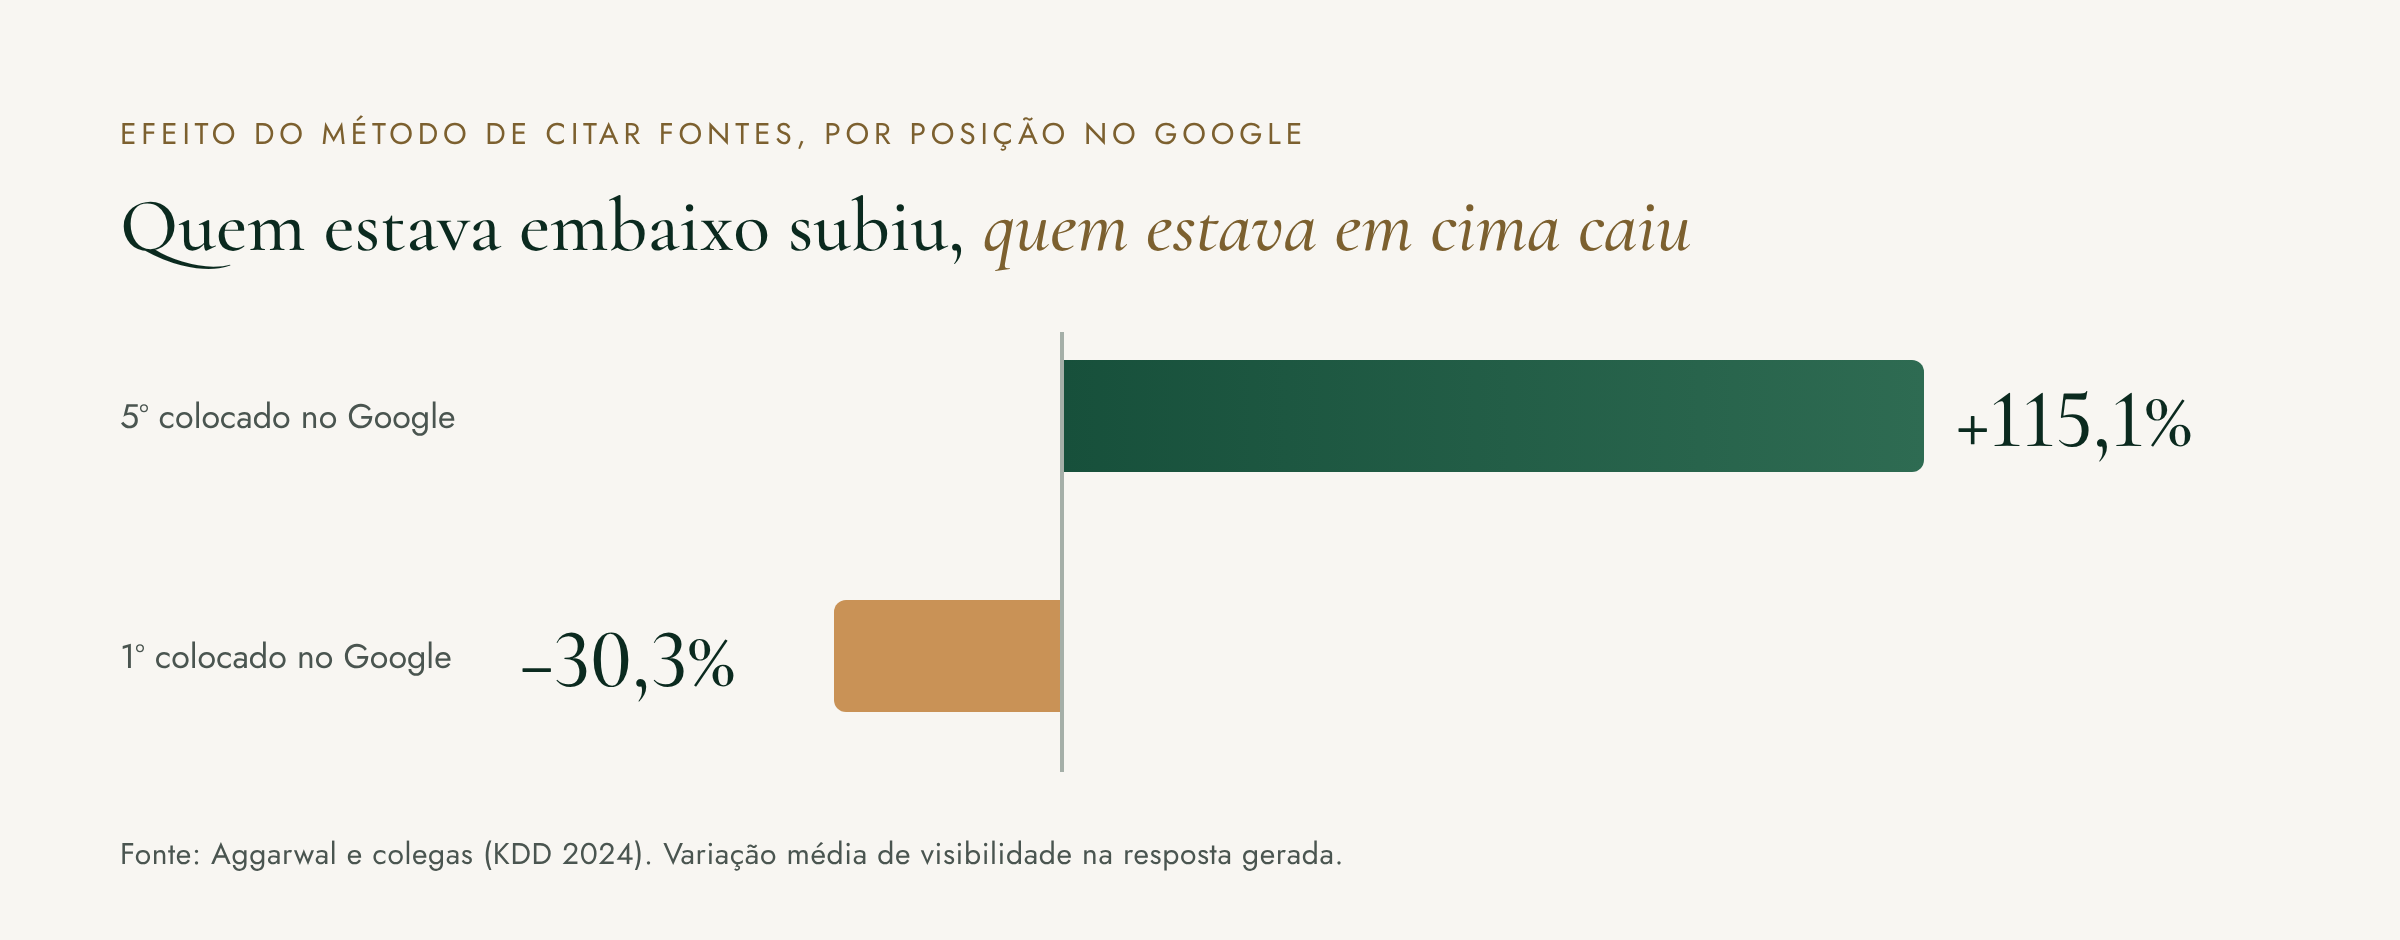
- Sites em posições mais baixas se beneficiaram mais, já que, com o método de citar fontes, o site que estava em quinto lugar no Google ganhou 115,1% de visibilidade, enquanto o primeiro colocado perdeu 30,3%.
- No Perplexity, a adição de falas de especialistas melhorou a métrica de palavras em 22%, e os melhores métodos chegaram a 37% de melhora na impressão subjetiva.
 (ampliar imagem)
O penúltimo número da lista merece uma pausa, porque o ajuste que mais ajudou quem estava embaixo foi o que mais atrapalhou quem estava em cima. Em laboratório, a citação de fontes funcionou como um corretor de ordem, aproximando das primeiras posições da resposta as fontes que estavam mais abaixo, o que é um dado valioso para quem começa de baixo, e um dado que as páginas de venda raramente contam por inteiro.
O que o estudo não consegue dizer
Os próprios resultados carregam limites que desaparecem quando o “40%” circula sozinho:
- Ambiente experimental, já que o mecanismo principal foi construído para o estudo, e o Perplexity, onde parte dos testes foi repetida, não é o Google.
- Visibilidade dentro de uma resposta sintética, e não negócio, porque as métricas medem quanto uma fonte aparece na resposta, e não tráfego, conversões ou receita.
- Modelos de 2023, e os sistemas mudaram muito desde então, sem garantia de que os efeitos se mantenham.
- Fontes, e não marcas, porque o estudo trata de fontes de informação, e não da decisão de nomear uma empresa entre outras.
- Variabilidade das respostas, já que, no estudo da SparkToro com a Gumshoe.ai relatado pelo Search Engine Land, a chance de duas respostas trazerem a mesma lista de marcas foi menor que 1 em 100, ou seja, um ganho médio medido em laboratório convive com um resultado instável na prática.
O que o estudo sustenta é um padrão editorial, e não um truque
O que outras pesquisas acrescentam
Em 2025, pesquisadores da Universidade de Toronto compararam as respostas de mecanismos de IA com as do Google e encontraram uma preferência sistemática e forte pela mídia independente, como veículos de imprensa e sites de avaliação, em detrimento do conteúdo da própria marca e das redes sociais, como mostra o artigo sobre o estudo de Toronto. Segundo o estudo, o ChatGPT e o Claude são os mais inclinados às fontes independentes, o Gemini incorpora mais conteúdo de marcas e o Perplexity, mais redes sociais.
Completam o quadro o guia oficial do Google para os recursos de IA generativa, publicado em 15 de maio de 2026 e resumido pelo Search Engine Roundtable, e estudos de mercado, como a análise da SE Ranking com cerca de 300 mil domínios sobre o llms.txt, relatada pelo Search Engine Journal, que, juntos, ajudam a separar o que tem evidência do que é modismo.
Uma escala de confiança
| Prática | O que se sabe | Tipo de evidência |
|---|---|---|
| Acrescentar estatísticas, fontes e falas de especialistas verificáveis | Aumentou a visibilidade em ambiente experimental (Princeton e parceiros) | Experimento controlado, com limites |
| Repetir palavras-chave | Pouco ou nenhum ganho (mesmo estudo) | Experimento controlado |
| Presença em mídia independente | Preferida pelos mecanismos analisados (Toronto, 2025) | Estudo comparativo observacional |
| Arquivo llms.txt | Sem relação com a frequência de citações (SE Ranking, cerca de 300 mil domínios), e o Google diz que não é necessário | Estudo observacional e documento oficial |
| Marcação especial para IA | O Google diz que não é necessária, e que não se deve focar demais em dados estruturados | Documento oficial |
| Dividir o texto em blocos para a IA | O guia do Google lista como desnecessário | Documento oficial |
| Produzir texto com IA em escala, sem revisão | Em 1º de outubro de 2026, o Google acrescentou à orientação sobre IA generativa a descrição de conteúdo feito com pouco ou nenhum esforço e lembrou que isso pode violar a política contra conteúdo em escala | Documento oficial |
| Buscar menções inautênticas | O guia do Google diz que não é preciso buscá-las | Documento oficial |
O que isso muda na redação
O que o estudo sustenta é um padrão editorial, com afirmações que trazem número, fonte e data, falas de especialistas reais e identificáveis e nenhuma repetição artificial de termos. Esse padrão serve ao leitor e às máquinas ao mesmo tempo, e não por coincidência, já que as máquinas foram treinadas com o que pessoas consideraram confiável, como detalha o artigo GEO na prática.
O que o estudo não autoriza é inventar uma estatística ou fabricar uma citação para ganhar visibilidade, o que seria fraude editorial, contraria o espírito da pesquisa e vai contra a orientação do Google, que, na atualização de outubro de 2026 da sua orientação sobre conteúdo gerado com IA, chamou de crítica a checagem manual dos fatos de todo conteúdo gerado com IA antes de publicar.
Perguntas frequentes
O estudo prova que o GEO funciona no ChatGPT?
Não, porque os testes principais foram feitos num mecanismo experimental, com uma parte repetida no Perplexity, e o estudo mostra que certas mudanças no texto afetam a presença da fonte em respostas geradas naquele ambiente.
O ganho de 40% vale para a minha empresa?
Não é uma previsão para nenhuma empresa, e sim um resultado relativo, medido numa métrica específica e em condições de laboratório, que depende do tipo de pergunta, do ponto de partida do site e do mecanismo de IA.
Vale acrescentar estatísticas em todos os textos?
Vale quando houver dado real, de fonte identificável e atual, e, onde não existe dado confiável, é melhor declarar a observação ou a hipótese de trabalho do que inventar um número.
O Tráfego IA foi desenvolvido dentro da Diamantino Estratégias, que aplica o método na presença digital de empresas.